OpenUs Lab 智能体实验室|技术研究博客
标题:WeKnora v0.8.0 深度评测:三位一体开源知识中台,智能体生态的私有知识底座
作者:OpenUs Lab 智能体实验室 发布时间:2026-09 标签:Agent、RAG、知识图谱、私有化部署、开源大模型、企业知识库。
摘要
随着Agent从Demo走向企业生产落地,最大短板不再是大模型推理能力,而是私有知识的可靠接入。腾讯开源 WeKnora v0.8.0,定位三位一体企业级知识中台,将RAG检索问答、ReAct Agent推理、AI自动Wiki图谱整合在一套系统内。不同于独立RAG工具,WeKnora内置Agent执行链路、会话级代码沙箱、跨会话长期记忆,可独立搭建企业知识库,也可作为外部智能体(HermCoze/Hermes Agent)的知识层插件。本文从新版本核心能力、架构拆解、能力边界、适用场景、与Agent编排引擎的组合方案做完整研判,为私有化智能体SaaS、企业内部知识大脑选型提供参考。
一、项目基础信息
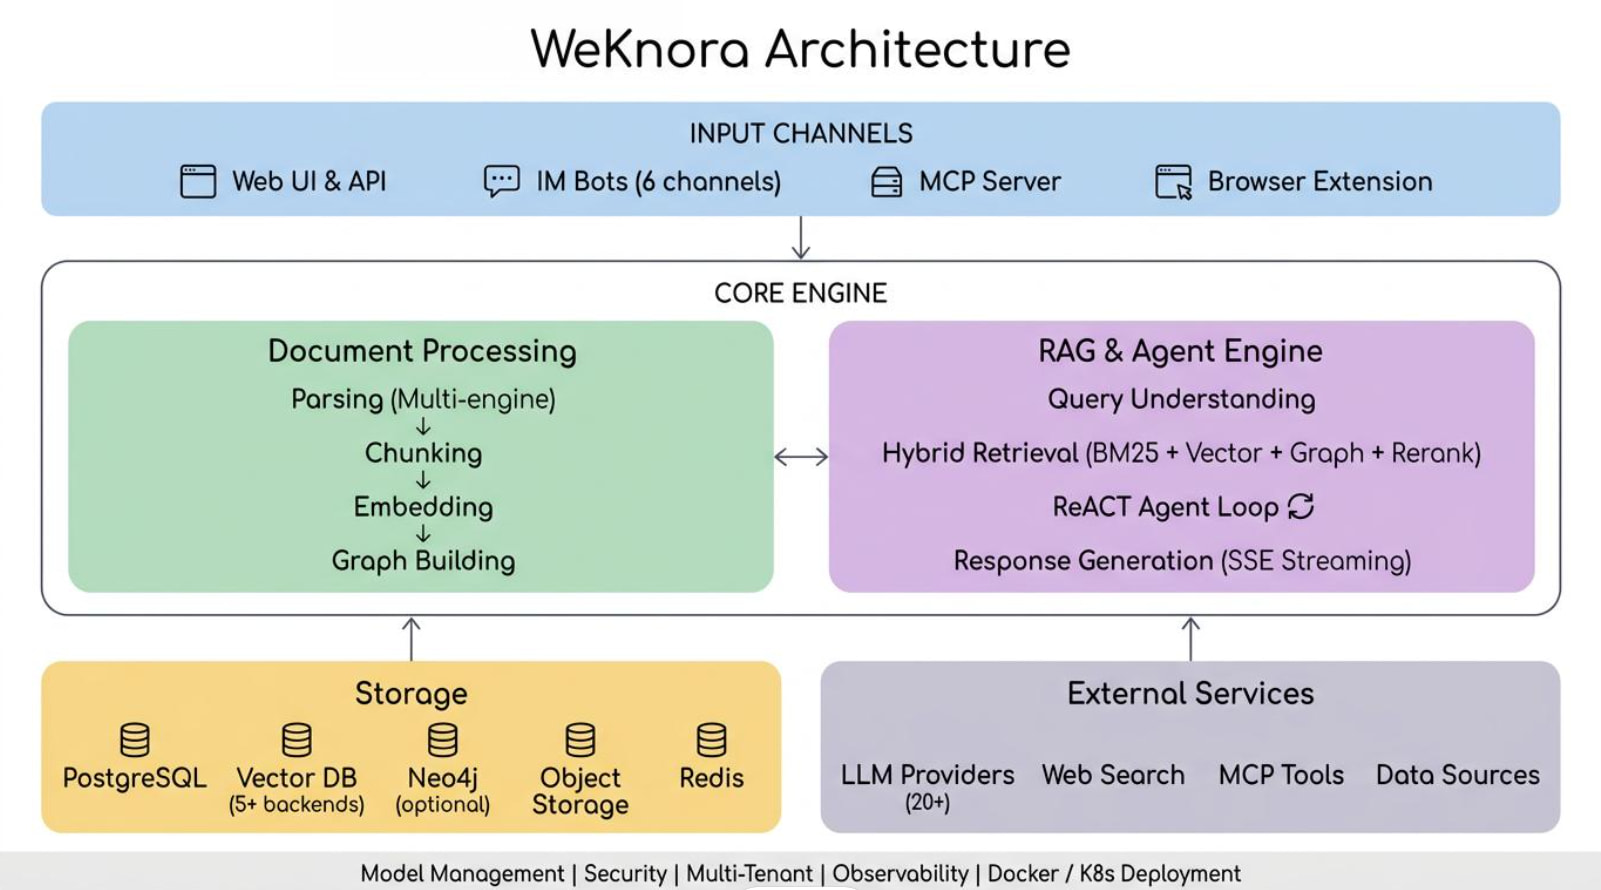
WeKnora为腾讯开源项目,MIT协议,Go语言后端,支持Docker、K8s/Helm一键私有化部署,数据可完全自持,全链路TLS传输、AES-256-GCM加密,原生支持多租户RBAC四级权限(Owner/Admin/Contributor/Viewer)与审计日志,面向企业文档知识沉淀场景。 **开源仓库地址:https://github.com/Tencent/WeKnora 当前最新稳定版:v0.8.0(2026-09-03)。本版本重点补齐三大短板:会话级安全沙箱、人工确认式长期记忆、可扩展Skill插件市场,打通知识库从“文档检索”走向“自主任务执行”的关键环节。
二、v0.8.0 核心能力解读
1. 三位一体核心引擎:RAG + ReAct Agent + AI Wiki图谱
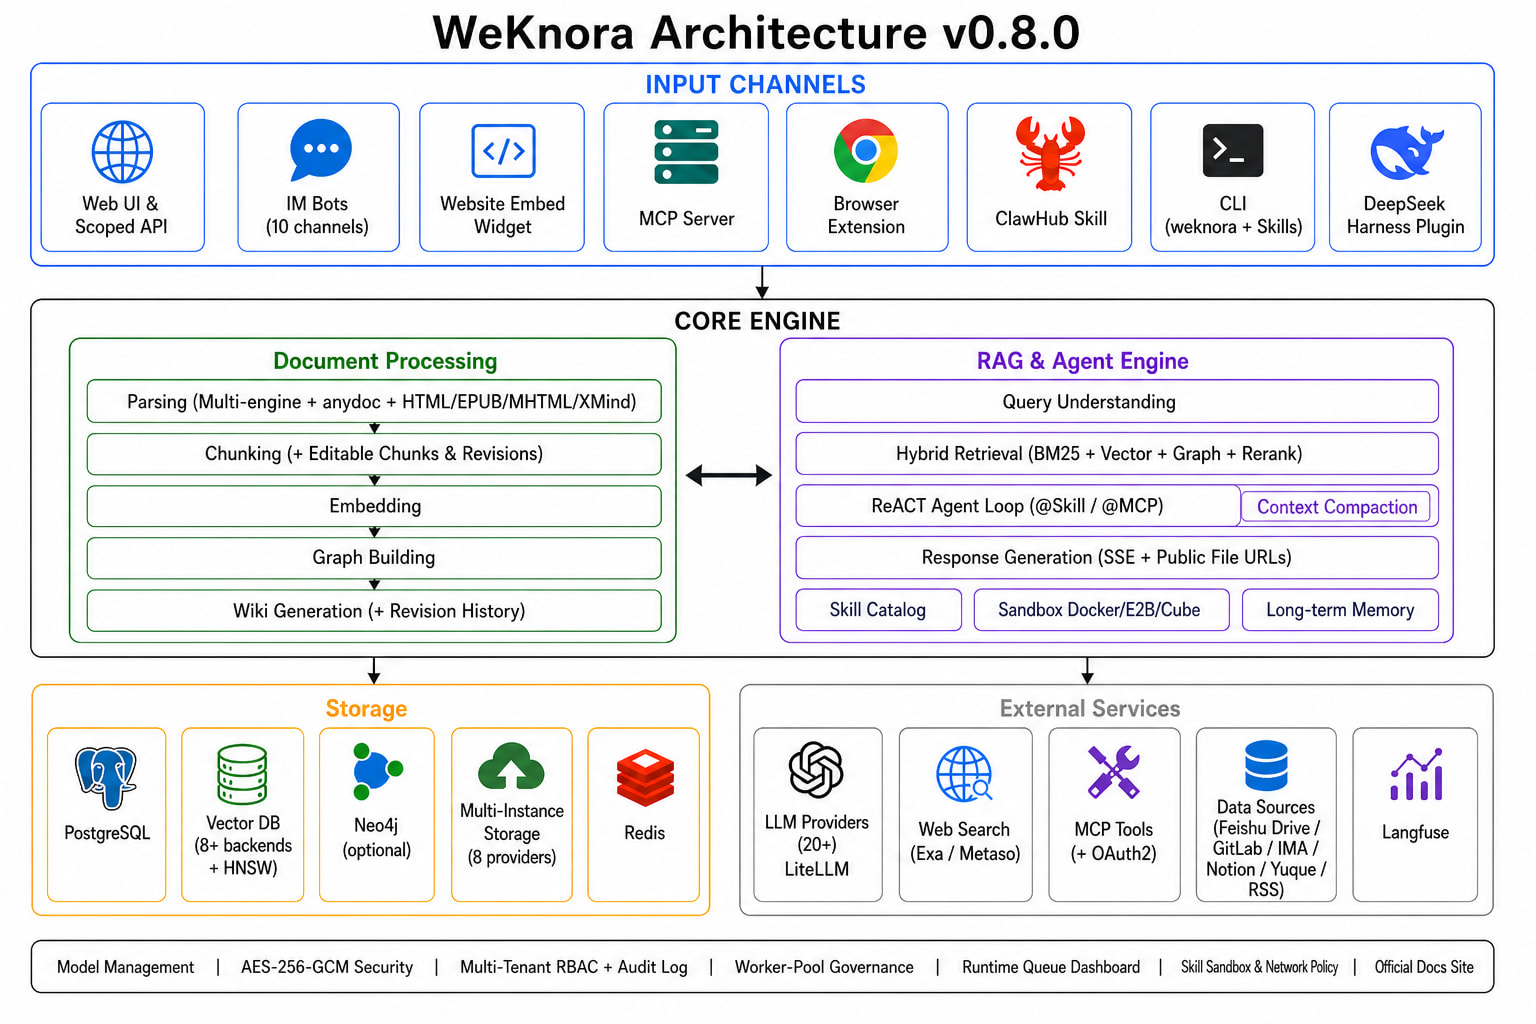
1)混合检索RAG问答 采用三路召回+重排架构:BM25关键词检索 + 向量稠密检索 + Graph知识图谱检索,答案自带原文片段溯源,大幅降低幻觉。分为「快速问答」毫秒级检索模式,以及深度Agent多跳推理模式,适合企业制度、合同、技术手册查询。 2)ReAct渐进式Agent 内置ReAct循环,可自主完成知识库检索、MCP工具调用、联网搜索、技能执行;支持人机审批节点,复杂任务可设置人工介入校验,避免Agent自主执行高风险操作。 3)自动Wiki+可视化知识图谱 批量上传原始文档,自动生成互相链接的Markdown维基页面,构建实体关系图谱;文档支持版本Diff、回滚,适合持续沉淀研发文档、项目资料,自动维护知识资产。
2. v0.8.0重磅新增特性
1)会话级Skill安全沙箱 支持Docker/E2B/Cube隔离沙箱,取消宿主机本地进程执行,可自定义网络访问策略;接入ClawHub技能市场,支持自定义技能安装,代码执行环境强隔离,解决Agent运行时代码执行安全风险。 2)跨会话长期记忆(人工确认机制) 自动提取5类记忆:用户画像、偏好设置、客观事实、待办任务、兴趣方向。
关键设计:系统自动提取记忆之后,默认处于「观察中」,必须人工确认,记忆才正式写入,杜绝无控制自动记忆带来的事实污染、幻觉记忆问题。记忆跨会话持久生效,持续优化检索权重。 3)Anydoc全文档解析引擎 Rust内置解析库,解析docx/xlsx/pptx保留图文原位结构;扫描PDF内置OCR识别,解决异构文档、扫描件入库难的痛点。 4)插件与多模型网关 原生支持LiteLLM网关对接,兼容OpenAI、Claude、DeepSeek、Ollama本地模型等20余种LLM;新增DeepSeek Harness插件、GitLab、IMA数据源,支持上下文压缩、Prompt Cache,降低LLM调用成本。 5)多渠道接入 WebUI、REST API、浏览器剪藏插件、钉钉/微信IM机器人,支持飞书、Notion文档双向同步,方便多端接入。
三、能力边界(选型核心,避坑要点)
-
定位边界:知识中台,不是通用Agent编排引擎
 强项:私有文档检索、文档归纳、多跳知识推理、合规溯源、知识库维护,适合做智能体的知识底座。
 短板:不擅长超长周期、跨数十套异构业务系统的复杂业务流程编排。如果业务需要大规模系统自动化,WeKnora只负责知识查询,任务调度、工具编排交给独立Agent引擎(HermCoze/Hermes Agent)。
-
幻觉无法根除 RAG+图谱能够显著降低幻觉,但不能完全消除。自动生成Wiki、知识图谱会出现实体关联错误,关键业务场景,图谱结论必须人工复核。
-
沙箱算力限制 Skill代码执行运行在隔离沙箱,默认限制外联;适合轻量脚本、数据处理,不适合大规模GPU算力、重型科学计算。
-
知识库规模上限 原生稳定承载万级文档;十万级海量文档场景,需要额外做分片分库二次开发,原生未提供分布式分片方案。
-
多模态局限 仅支持图片OCR文字提取,不支持图像理解、视频内容解析,图片只能提取文字入库,无法看图推理。
-
记忆管控边界 长期记忆默认关闭,且必须人工确认写入;不会无限制自动记录全部对话,适合企业合规场景,但会牺牲一部分全自动智能体验。
四、适用场景 & 不适合场景
推荐落地场景
- 企业内部知识库问答:制度、SOP、研发手册,员工自助查询,答案带原文引用,用于新员工培训、内部咨询。
- 法务/合规知识库:法规、合同、审计文件,自动构建条款关联图谱,支持条款比对、变更追溯。
- 技术支持智能客服:产品手册、故障知识库,对接IM渠道,自助故障诊断,降低客服人力成本。
- 科研/研发文献管理:论文、技术报告批量入库,自动生成文献Wiki,辅助文献调研、资料梳理。
- 智能体SaaS的知识底座(重点适配OpenUs Lab HermCoze方案) 架构分工:HermCoze/Hermes Agent负责任务规划、工具编排、对话逻辑;WeKnora独立承担私有知识库检索、文档理解。Agent通过API调用WeKnora获取私有资料,构成「编排引擎 + 知识中台」分层架构,非常适合出海Agent SaaS、企业本地化定制部署。
- 团队/个人私有知识库:网页剪藏、本地文档归集,自动整理Wiki,沉淀个人知识资产。
不推荐场景
- 纯闲聊对话,无私有文档场景(直接调用基础大模型更合适)
- 图像生成、视频理解、复杂视觉推理任务
- 大规模高并发代码运算、重型数值仿真
- 超长跨系统自动化业务流程(WeKnora只做知识查询)
五、OpenUs Lab 落地建议:WeKnora + HermCoze 组合架构
在我们的智能体实验室实测中,不要将WeKnora作为完整Agent执行层,最佳方案是分层解耦:
- WeKnora:知识层 文档解析、向量存储、混合检索、知识图谱、私有资料问答,对外输出标准化检索API。
- HermCoze / Hermes Agent:Agent编排层 负责用户意图拆解、多步骤任务规划、MCP工具调度、对话管理、会话状态管理。
- 通信链路:Agent通过API调用WeKnora知识库,获取带引用的检索结果,再交由大模型生成回答。 这套架构优势:知识资产和智能体业务逻辑解耦,知识库可以独立扩容、独立权限管控,满足企业私有化部署、海外SaaS多租户隔离需求。
六、总结
WeKnora v0.8.0代表开源RAG产品的一个重要方向:不再只做简单文档问答,而是自带轻量Agent、沙箱执行、知识图谱,成长为完整的企业知识中枢。 它的核心价值,是给各类智能体提供一个可私有化、可溯源、安全可控的私有知识底座。对于Agent创业团队,不必从零开发整套RAG、文档解析、权限系统,可以直接复用WeKnora,把研发重心放在智能体任务编排、产品交互层面。 同时必须清醒认知其边界:它是知识中台,而非全能Agent引擎。生产级项目,建议搭配独立Agent编排系统,分层构建,避免架构耦合带来后期迭代风险。
OpenUs Lab 智能体实验室,持续跟踪开源Agent、RAG、算力基础设施项目,专注智能体SaaS、私有化部署与海外落地技术研究。
